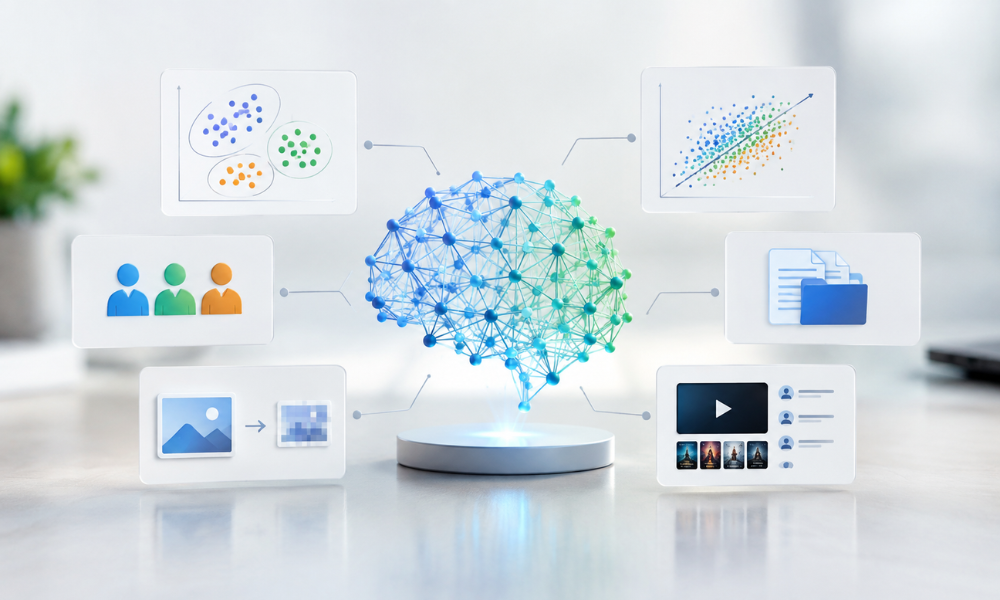
En grandissant, nous apprenons certaines choses auprès de nos parents ou de nos tuteurs, mais nous apprenons également beaucoup de choses au fil du temps grâce à nos expériences. Ces expériences peuvent nous amener à prendre consciemment des décisions pour nous améliorer ou à apprendre inconsciemment certains schémas, puis à les appliquer à de nouvelles situations. C’est ainsi que fonctionne la méthode d’apprentissage non supervisé dans le domaine de l’intelligence artificielle.
Dans cet article de blog, nous allons comprendre les algorithmes d’apprentissage non supervisé, un type d’apprentissage automatique, ainsi que leurs différentes catégories, leurs algorithmes et certains exemples concrets qu’il est important de connaître.
Qu’est-ce qu’un algorithme d’apprentissage non supervisé ?
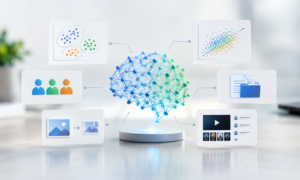
Le processus qui consiste à identifier les schémas cachés dans des données historiques réelles est appelé apprentissage automatique non supervisé. Dans cette méthode, sans aide ni intervention humaine, le modèle d’apprentissage automatique tente d’identifier lui-même les similitudes, les différences, les tendances et la structure présentes dans les données. Ces algorithmes sont particulièrement efficaces lorsque l’étiquetage manuel des données est difficile, peu pratique ou impossible, notamment pour comprendre le comportement des clients, détecter les fraudes ou organiser de vastes ensembles de données.
Les deux principaux types d’algorithmes d’apprentissage non supervisé sont :
Clustering
Regroupement des données en clusters fondés sur leurs similitudes.
Réduction de la dimensionnalité
Réduction du nombre de caractéristiques tout en conservant les informations importantes afin de simplifier les données.
Ces méthodes constituent la base de nombreuses applications concrètes, ce qui les rend précieuses aussi bien pour les entreprises que pour les chercheurs.
Plus de 5 exemples concrets d’algorithmes d’apprentissage non supervisé
1. Segmentation des clients dans le marketing
Les entreprises utilisent les algorithmes d’apprentissage non supervisé pour répartir leurs clients en différents segments. Les algorithmes de clustering, tels que K-Means, analysent les habitudes d’achat, les préférences et les données démographiques afin d’identifier des groupes distincts. Ces informations permettent aux spécialistes du marketing de créer des campagnes ciblées, d’améliorer l’expérience client et d’augmenter les taux de fidélisation.
Par exemple, une plateforme de commerce électronique peut utiliser le clustering pour répartir ses clients dans des catégories telles que les « acheteurs fréquents », les « amateurs de réductions » et les « nouveaux visiteurs ». En comprenant ces groupes, les entreprises peuvent adapter efficacement leurs stratégies.
2. Détection des anomalies pour identifier les fraudes
Les algorithmes d’apprentissage non supervisé jouent un rôle essentiel dans l’identification de schémas inhabituels dans les transactions financières. Des algorithmes tels que les forêts d’isolation (Isolation Forest) ou DBSCAN détectent les valeurs aberrantes susceptibles d’indiquer des activités frauduleuses.
Les banques et les institutions financières s’appuient sur ces méthodes pour analyser d’importants volumes de données et signaler les comportements suspects en temps réel. Cette approche proactive contribue à réduire les risques et à préserver la confiance des clients.
3. Compression des images
Dans le domaine de la vision par ordinateur, des algorithmes de réduction de la dimensionnalité tels que l’analyse en composantes principales (ACP ou PCA) sont utilisés pour compresser les images. Ces algorithmes réduisent la taille des fichiers image sans compromettre de manière significative leur qualité.
En identifiant et en conservant uniquement les caractéristiques les plus importantes d’une image, les entreprises peuvent économiser de l’espace de stockage et de la bande passante. Cette approche est particulièrement utile dans des secteurs tels que le commerce électronique, les réseaux sociaux et la création de contenu numérique.
4. Organisation des documents dans la gestion de contenu
Les algorithmes de clustering, tels que le clustering hiérarchique, permettent d’organiser et de catégoriser de grandes collections de documents. Les bibliothèques, les cabinets juridiques et les entreprises de médias utilisent ces algorithmes pour regrouper les articles, les travaux de recherche et les documents juridiques par sujet ou par thème.
Cette approche améliore la facilité de recherche, réduit les redondances et accroît la productivité, notamment lorsqu’il s’agit de gérer d’importants référentiels d’informations.
5. Systèmes de recommandation
Les systèmes de recommandation utilisés par des plateformes telles que Netflix et Spotify exploitent des algorithmes d’apprentissage non supervisé afin de proposer des suggestions personnalisées. En analysant les préférences et les habitudes des utilisateurs, ces systèmes regroupent les utilisateurs ou les contenus similaires afin de générer des recommandations adaptées aux goûts de chacun.
Par exemple, si vous regardez fréquemment des films de science-fiction, le système de recommandation de Netflix peut vous proposer d’autres titres de science-fiction en se basant sur les habitudes de visionnage d’utilisateurs ayant des préférences similaires.
Exemple bonus : recherche génétique et soins de santé
Les algorithmes d’apprentissage non supervisé transforment le secteur de la santé en permettant d’analyser les données génétiques. Les techniques de clustering et de réduction de la dimensionnalité permettent d’identifier des schémas dans les séquences d’ADN, contribuant ainsi à la découverte de troubles génétiques et au développement de traitements personnalisés.
Les chercheurs utilisent ces algorithmes pour regrouper des profils génétiques similaires et identifier les mutations associées à certaines pathologies. Cette approche présente des implications importantes pour la médecine de précision et le développement de médicaments.
Pourquoi les algorithmes d’apprentissage non supervisé sont-ils importants ?
Les algorithmes d’apprentissage non supervisé permettent de révéler des schémas cachés dans les données qui ne sont pas forcément immédiatement perceptibles. En automatisant la reconnaissance et l’analyse des schémas, ils permettent de gagner du temps, de réduire les efforts humains et de mettre en évidence des informations exploitables. Les entreprises et les chercheurs bénéficient ainsi de leur polyvalence et de leur efficacité.
De plus, ces algorithmes évoluent continuellement et ouvrent de nouvelles possibilités dans des secteurs tels que la santé, la finance et le divertissement. Qu’il s’agisse d’améliorer l’expérience utilisateur ou de lutter contre la cybercriminalité, leurs applications potentielles sont nombreuses.
Réflexions finales
Les algorithmes d’apprentissage non supervisé révolutionnent notre manière d’analyser et d’interpréter les données. En comprenant leurs principes et leurs applications, vous pouvez mieux apprécier leur rôle transformateur dans le monde actuel, fondé sur les données. Les exemples présentés ne représentent qu’une petite partie de leur potentiel et montrent comment ces algorithmes influencent notre vie quotidienne de manière souvent invisible, mais significative.
À mesure que l’intelligence artificielle et l’apprentissage automatique continuent de progresser, l’importance des algorithmes d’apprentissage non supervisé ne fera que croître. L’adoption de ces technologies permet aux entreprises et aux chercheurs de découvrir des informations plus approfondies et de stimuler l’innovation.